

Contenuto generato con IA Dettagli
Il passaggio da monolite a microservizi rappresenta oggi la sfida architetturale più critica per le aziende del settore fintech e dell’intermediazione creditizia. Nel 2026, la modernizzazione delle piattaforme legacy non è più solo una questione di efficienza tecnica, ma un imperativo di sopravvivenza per competere in un mercato dominato da Open Finance e normative in rapida evoluzione. Questa guida strategica e tecnica esplora come decomporre un’applicazione monolitica gestendo la complessità dei dati transazionali, la resilienza delle integrazioni bancarie e l’automazione infrastrutturale.
1. Il Contesto: Perché il Settore del Credito deve Evolvere
Le piattaforme di gestione del credito nascono spesso come architetture monolitiche: un singolo blocco di codice in cui l’interfaccia utente, la logica di business (scoring, istruttoria, erogazione) e l’accesso ai dati sono strettamente accoppiati. Sebbene questo approccio garantisca inizialmente semplicità di sviluppo e transazioni ACID (Atomicity, Consistency, Isolation, Durability) native grazie a un unico database relazionale, nel lungo periodo diventa un collo di bottiglia.
I problemi principali che affrontiamo nel credito sono:
- Scalabilità limitata: Impossibile scalare solo il modulo di “Calcolo Rata” senza replicare l’intera applicazione.
- Cicli di rilascio lenti: Una modifica normativa sul calcolo del TAEG richiede il redeploy dell’intero sistema, aumentando il rischio di regressioni.
- Single Point of Failure: Un errore nel modulo di generazione PDF può bloccare l’intero portale di richiesta prestiti.
2. Strategia di Decomposizione: Domain-Driven Design (DDD)
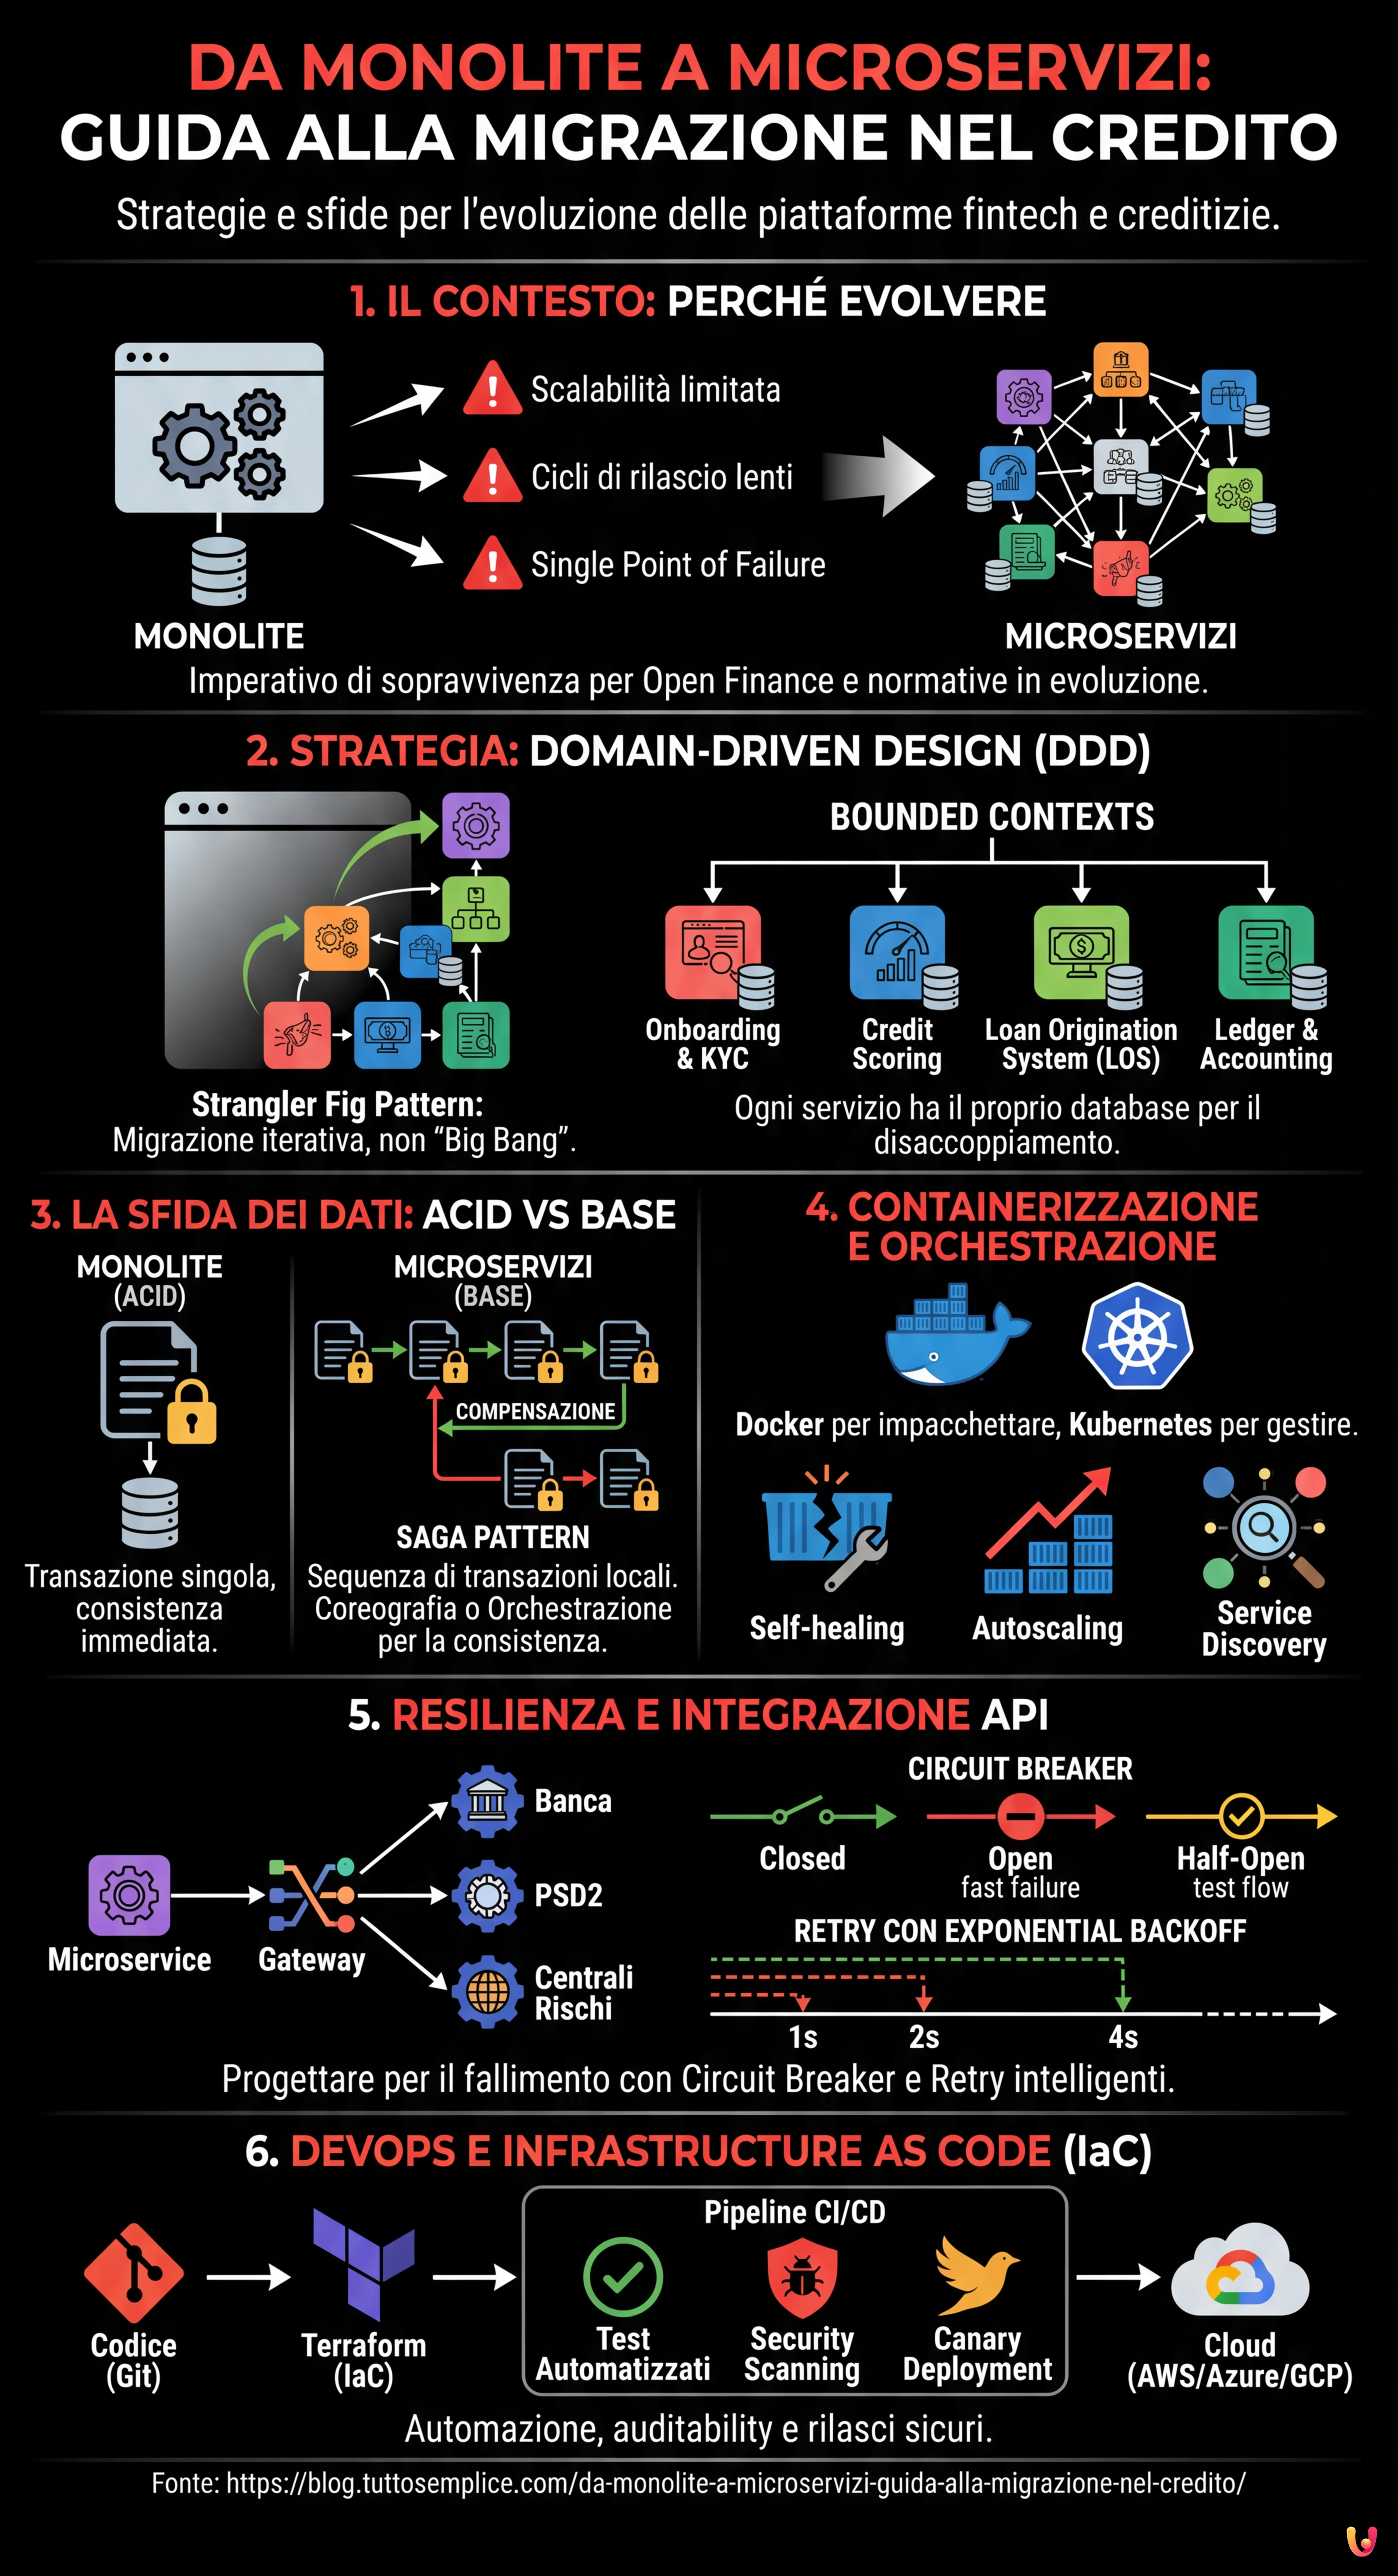 Immagine generata con IA
La migrazione da monolite a microservizi non deve mai essere un “Big Bang” (riscrittura totale simultanea), ma un processo iterativo basato sul pattern Strangler Fig (Fico Strangolatore), come teorizzato da Martin Fowler. Il primo passo non è scrivere codice, ma definire i confini.
Identificare i Bounded Contexts
Utilizzando i principi del Domain-Driven Design (DDD), dobbiamo mappare i sottodomini funzionali. Nel credito, i confini naturali (Bounded Contexts) potrebbero essere:
- Onboarding & KYC: Gestione anagrafica e antiriciclaggio.
- Credit Scoring: Motore decisionale e interrogazione Crif/Experian.
- Loan Origination System (LOS): Workflow della pratica.
- Ledger & Accounting: Gestione dei movimenti contabili.
Ogni microservizio deve possedere il proprio database (pattern Database-per-Service) per garantire il disaccoppiamento. Questo introduce la sfida tecnica più grande: la consistenza dei dati.
3. La Sfida dei Dati: ACID vs BASE in Ambiente Distribuito
 Immagine generata con IA
In un monolite bancario, trasferire fondi e aggiornare lo stato della pratica avviene in una singola transazione database. In un’architettura a microservizi, queste operazioni avvengono su servizi diversi. Non possiamo usare transazioni distribuite classiche (Two-Phase Commit) a causa della latenza e del blocco delle risorse.
Implementare il Saga Pattern
Per mantenere la consistenza, adottiamo il Saga Pattern. Una Saga è una sequenza di transazioni locali. Se una transazione fallisce, la Saga esegue una serie di transazioni di compensazione per annullare le modifiche precedenti.
Esistono due approcci principali:
- Coreografia: I servizi si scambiano eventi (es. tramite Kafka o RabbitMQ). Il servizio Scoring emette l’evento
ScoringCompleted, che viene ascoltato dal servizio Origination. - Orchestrazione: Un servizio centrale (Orchestrator) comanda agli altri cosa fare. Nel contesto creditizio, dove i workflow sono complessi e normati, l’orchestrazione è spesso preferibile per avere visibilità sullo stato della pratica.
4. Containerizzazione e Orchestrazione: Docker e Kubernetes
Una volta definiti i servizi, la tecnologia abilitante è la containerizzazione. Docker permette di impacchettare ogni microservizio con le sue dipendenze (librerie, runtime), garantendo che l’ambiente di sviluppo sia identico a quello di produzione.
Per gestire decine o centinaia di container, Kubernetes (K8s) è lo standard de facto. K8s offre:
- Self-healing: Riavvia automaticamente i container che falliscono (es. un servizio di preventivazione che crasha per memoria insufficiente).
- Autoscaling: Aumenta le repliche dei pod durante i picchi di richieste (es. campagne marketing Black Friday).
- Service Discovery: Gestisce il routing del traffico interno tra i microservizi senza hard-coding degli IP.
5. Resilienza e Integrazione con API Bancarie Esterne
Un intermediario creditizio deve dialogare con molteplici API esterne (Banche, PSD2 Gateway, Centrali Rischi). Queste API sono soggette a latenza, timeout o indisponibilità temporanea. Un’architettura a microservizi deve essere progettata per il fallimento.
Circuit Breaker Pattern
È essenziale implementare il pattern Circuit Breaker (utilizzando librerie come Resilience4j o le funzionalità di Service Mesh come Istio). Funziona come un interruttore elettrico:
- Closed: Il traffico scorre normalmente.
- Open: Se il numero di errori supera una soglia (es. 5 timeout consecutivi verso l’API della Banca X), il circuito si apre e le chiamate falliscono immediatamente senza attendere il timeout, preservando le risorse del sistema.
- Half-Open: Dopo un periodo di tempo, il sistema lascia passare alcune richieste di prova per verificare se il servizio esterno è tornato online.
Retry con Exponential Backoff
Per errori transitori, implementiamo politiche di Retry intelligenti. Non riprovare immediatamente, ma attendere tempi crescenti (es. 1s, 2s, 4s) per non sovraccaricare un sistema già in sofferenza (Exponential Backoff).
6. DevOps e Infrastructure as Code (IaC)
La complessità operativa dei microservizi richiede un approccio DevOps maturo. Non è pensabile gestire manualmente l’infrastruttura.
Terraform e GitOps
Utilizziamo Terraform per definire l’infrastruttura come codice (IaC). Questo permette di versionare l’architettura cloud (AWS/Azure/GCP) su Git, garantendo auditability e riproducibilità, requisiti fondamentali per le ispezioni di Banca d’Italia o BCE.
Pipeline CI/CD
Le pipeline di Continuous Integration e Continuous Deployment devono includere:
- Test Automatizzati: Unit test, Integration test e Contract test (per verificare che le API non abbiano rotto la compatibilità).
- Security Scanning: Analisi statica del codice (SAST) e scansione delle immagini Docker per vulnerabilità note (CVE).
- Canary Deployment: Rilasciare la nuova versione del microservizio solo a una piccola percentuale di utenti per verificare la stabilità prima del rollout completo.
In Breve (TL;DR)
La modernizzazione delle piattaforme legacy verso i microservizi è vitale per competere efficacemente nel dinamico settore del credito e fintech.
Una strategia basata su Domain-Driven Design e pattern Saga risolve le complessità legate alla decomposizione e alla consistenza dei dati.
L’utilizzo di Kubernetes e protocolli di resilienza assicura scalabilità e affidabilità operativa nelle integrazioni critiche con i sistemi bancari.
Conclusioni

Migrare da monolite a microservizi nel settore del credito non è un semplice aggiornamento tecnologico, ma una ristrutturazione profonda dei processi operativi. Richiede una gestione rigorosa della consistenza dei dati tramite pattern come Saga, una resilienza proattiva tramite Circuit Breaker e un’automazione totale tramite DevOps. Solo così l’innovazione tecnologica può tradursi in velocità di business, permettendo di lanciare nuovi prodotti finanziari in giorni invece che in mesi, mantenendo al contempo la robustezza e la sicurezza richieste dal regolatore.
Domande frequenti

La migrazione verso i microservizi è necessaria per superare i limiti di scalabilità e la lentezza dei rilasci tipici delle architetture monolitiche. Nel fintech, questo passaggio è cruciale per adattarsi rapidamente alle normative, come le modifiche sul calcolo del TAEG, e per competere nel mercato Open Finance, permettendo di aggiornare singoli moduli senza rischiare di bloccare l’intera piattaforma.
In un ambiente a microservizi, dove non è possibile utilizzare le transazioni ACID classiche su un unico database, si adotta il Saga Pattern. Questo metodo gestisce la consistenza attraverso una sequenza di transazioni locali coordinate via orchestrazione o coreografia. Se un passaggio fallisce, il sistema esegue automaticamente transazioni di compensazione per annullare le modifiche precedenti e mantenere l’integrità dei dati finanziari.
L’approccio più efficace evita la riscrittura totale simultanea, nota come Big Bang, favorendo invece un processo iterativo basato sul pattern Strangler Fig. Utilizzando il Domain-Driven Design, si identificano i confini funzionali o Bounded Contexts, come il Credit Scoring o l’Onboarding, per estrarre e modernizzare progressivamente singole parti del sistema riducendo i rischi operativi.
Sono meccanismi fondamentali per garantire la resilienza quando si comunica con API esterne instabili. Il Circuit Breaker interrompe le chiamate verso un servizio che restituisce errori ripetuti, prevenendo il blocco delle risorse interne. Le politiche di Retry con Exponential Backoff, invece, gestiscono i nuovi tentativi di connessione attendendo intervalli di tempo crescenti, evitando di sovraccaricare i sistemi esterni già in difficoltà.
Kubernetes è essenziale per gestire la complessità dei container in produzione, offrendo funzionalità critiche come il self-healing, che riavvia automaticamente i servizi in crash, e l’autoscaling. Quest’ultimo permette all’infrastruttura di adattarsi dinamicamente ai picchi di carico, garantendo continuità operativa durante momenti critici come campagne marketing o scadenze fiscali.
Hai ancora dubbi su Da Monolite a Microservizi: Guida alla Migrazione nel Credito?
Digita qui la tua domanda specifica per trovare subito la risposta ufficiale di Google.
Fonti e Approfondimenti


Hai trovato utile questo articolo? C’è un altro argomento che vorresti vedermi affrontare?
Scrivilo nei commenti qui sotto! Prendo ispirazione direttamente dai vostri suggerimenti.