

Contenuto generato con IA Dettagli
Nel panorama digitale del 2026, dove l’intelligenza artificiale e i Large Language Models (LLM) influenzano sempre più il modo in cui i motori di ricerca processano le informazioni, l’architettura dell’informazione rimane il pilastro fondamentale per i siti ad alto volume di traffico. Per i grandi aggregatori, la sfida principale risiede nella SEO Tecnica per Portali Comparativi: Gestione della Faceted Navigation (navigazione a faccette). Questa guida tecnica è progettata per CTO, SEO Manager e sviluppatori che operano su portali Fintech (come il caso studio di MutuiperlaCasa.com) o immobiliari, dove milioni di combinazioni di filtri possono trasformarsi nel peggior incubo per il Crawl Budget.
1. Il Problema Matematico: Combinatoria e Diluizione dell’Autorità
La navigazione a faccette permette agli utenti di filtrare i risultati in base a molteplici attributi. In un portale di mutui, un utente potrebbe selezionare:
- Tipo di tasso: Fisso, Variabile, Misto.
- Durata: 10, 15, 20, 25, 30 anni.
- Importo: Scaglioni di 5.000€.
- Banca: 20+ istituti.
Matematicamente, questo genera un’esplosione combinatoria. Se Googlebot tentasse di scansionare ogni possibile permutazione di URL generata da questi filtri, il Crawl Budget verrebbe esaurito scansionando pagine a basso valore (es. “Mutuo tasso misto, 13 anni, Banca X, importo 125.000€”), lasciando fuori dall’indice le pagine core ad alta conversione. Questo fenomeno porta a:
- Index Bloat: L’indice di Google si riempie di pagine duplicate o “thin content”.
- Cannibalizzazione delle Keyword: Migliaia di pagine competono per le stesse query.
- Diluizione del PageRank: L’autorità del dominio viene dispersa su URL inutili.
2. Strategie di Controllo: Robots.txt, Noindex e Canonical
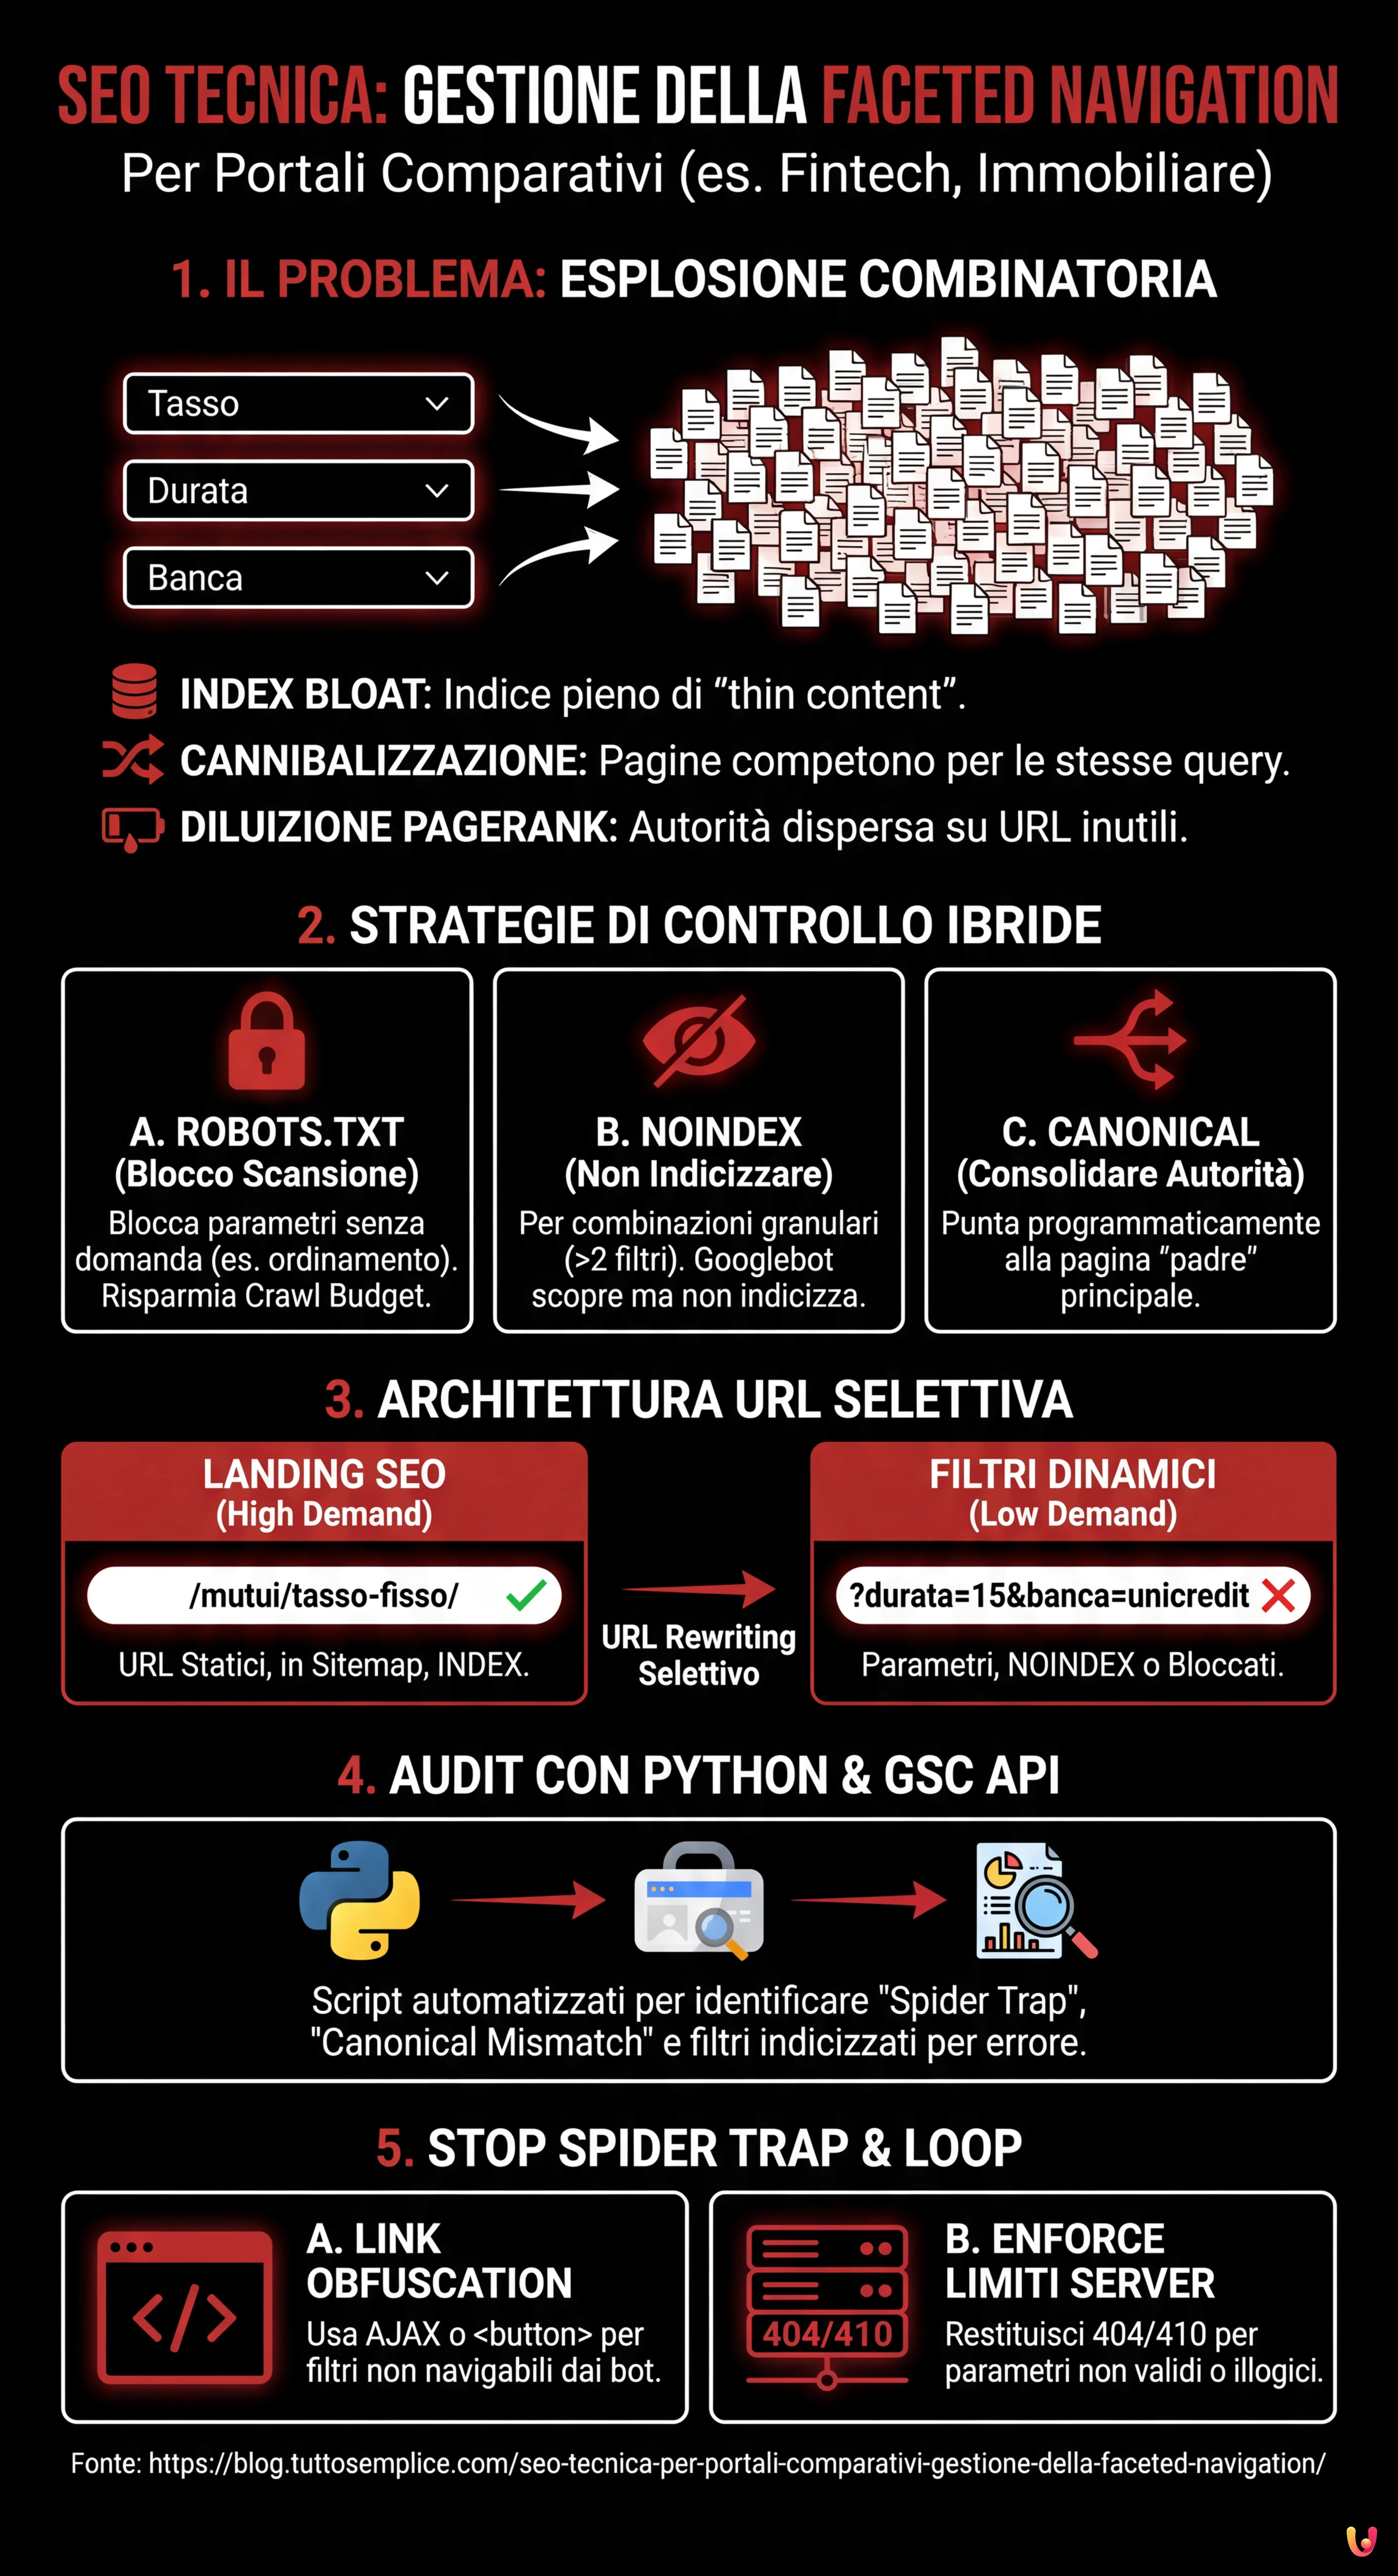 Immagine generata con IA
Non esiste una soluzione unica. La gestione corretta richiede un approccio ibrido basato sulla priorità di scansione e indicizzazione.
A. Il File Robots.txt: La Prima Linea di Difesa
Per i portali comparativi, il robots.txt è essenziale per preservare le risorse di scansione. È necessario bloccare i parametri che non generano domanda di ricerca (search demand) o che creano contenuti duplicati.
Esempio pratico: In un portale di mutui, l’ordinamento (prezzo crescente/decrescente) non cambia il contenuto, solo l’ordine. Questo deve essere bloccato.
User-agent: Googlebot
Disallow: /*?order=*
Disallow: /*?price_min=*
Disallow: /*?price_max=*
Nota: Bloccare via robots.txt impedisce la scansione, ma non rimuove necessariamente le pagine dall’indice se queste sono linkate esternamente. Tuttavia, è il metodo più efficace per risparmiare Crawl Budget.
B. Meta Robots “noindex, follow”
Per le combinazioni di filtri che vogliamo che Googlebot scopra (per seguire i link ai prodotti) ma non indicizzi, utilizziamo il tag noindex.
Regola Aurea: Applicare noindex quando l’utente applica più di 2 filtri contemporaneamente. Una pagina “Mutui Tasso Fisso” ha valore SEO. Una pagina “Mutui Tasso Fisso + 20 Anni + Intesa Sanpaolo” è probabilmente troppo granulare e dovrebbe essere esclusa dall’indice.
C. Canonical Tag Programmatico
Il tag canonical è un suggerimento, non una direttiva. Nei portali comparativi, deve essere gestito programmaticamente per consolidare l’autorità verso la pagina “padre”.
Se un utente atterra su /mutui/tasso-fisso?session_id=123, il canonical deve puntare tassativamente a /mutui/tasso-fisso. Tuttavia, l’uso eccessivo del canonical su pagine molto diverse (es. canonicalizzare una pagina filtrata verso la categoria generale) può essere ignorato da Google se il contenuto differisce troppo.
3. Architettura URL e Gestione dei Parametri
 Immagine generata con IA
Secondo le best practice di Google Search Central, l’utilizzo di parametri standard (?key=value) è spesso preferibile per la faceted navigation rispetto agli URL statici simulati (/valore1/valore2), perché permette a Google di capire meglio la struttura dinamica.
La Logica di MutuiperlaCasa.com
Nel nostro scenario operativo, abbiamo implementato una logica di URL Rewriting Selettivo:
- Landing Page SEO (High Demand): Trasformiamo i parametri in URL statici.
Es:?tipo=fissodiventa/mutui/tasso-fisso/. Queste pagine sono presenti nella Sitemap XML e sono indicizzabili. - Filtri Dinamici (Low Demand): Rimangono parametri.
Es:?durata=15&banca=unicredit. Queste pagine hannonoindexo sono bloccate via robots.txt a seconda del volume.
4. Audit Automatizzato con Python e GSC API
Gestire milioni di URL manualmente è impossibile. Nel 2026, l’uso di Python per interrogare le API di Google Search Console è uno standard per i Technical SEO. Di seguito, presentiamo uno script per identificare le “Spider Trap” e le pagine orfane causate dai filtri.
Prerequisiti
- Account Google Cloud Platform con API Search Console abilitata.
- Librerie Python:
pandas,google-auth,google-searchconsole.
Lo Script di Analisi
Questo script estrae lo stato di copertura degli URL filtrati per identificare anomalie (es. parametri che dovrebbero essere bloccati ma vengono indicizzati).
import pandas as pd
import websearch_google_search_console as gsc

# Autenticazione (sostituire con le proprie credenziali)
account = gsc.authenticate(client_config='client_secrets.json')
webproperty = account['https://www.mutuiperlacasa.com/']

# 1. Estrazione dati di copertura (Inspection API)
# Nota: L'API ha limiti di quota, usare con parsimonia o su campioni
urls_to_check = [
    'https://www.mutuiperlacasa.com/mutui?tasso=fisso&durata=30',
    'https://www.mutuiperlacasa.com/mutui?tasso=variabile&order=asc',
    # ... lista di URL sospetti generati dai log del server
]

results = []

for url in urls_to_check:
    try:
        inspection = webproperty.inspect(url)
        results.append({
            'url': url,
            'index_status': inspection.index_status_result.status,
            'robots_txt_state': inspection.index_status_result.robots_txt_state,
            'indexing_state': inspection.index_status_result.indexing_state,
            'user_canonical': inspection.index_status_result.user_canonical,
            'google_canonical': inspection.index_status_result.google_canonical
        })
    except Exception as e:
        print(f"Errore su {url}: {e}")

# 2. Analisi dei Dati con Pandas
df = pd.DataFrame(results)

# Identificare URL che Google ha scelto come canonical diverso da quello dichiarato
canonical_mismatch = df[df['user_canonical'] != df['google_canonical']]

print("Canonical Mismatch Found:")
print(canonical_mismatch)

# Identificare URL indicizzati che dovrebbero essere bloccati
leaking_filters = df[(df['url'].str.contains('order=')) & (df['index_status'] == 'INDEXED')]

print("Filtri 'order' indicizzati per errore:")
print(leaking_filters)
Interpretazione dei Risultati
Se lo script rileva che URL contenenti order=asc sono nello stato INDEXED, significa che le regole del robots.txt non sono state applicate retroattivamente o che ci sono link interni massivi che puntano a queste risorse. In questo caso, l’azione correttiva è implementare un tag noindex temporaneo per rimuoverle, prima di bloccarle nuovamente.
5. Gestione degli Spider Trap e Loop Infiniti
Uno dei rischi maggiori nei portali comparativi è la generazione di calendari o filtri prezzo infiniti (es. /prezzo/100-200, /prezzo/101-201). Per risolvere questo problema:
- Obfuscation dei Link: Utilizzare tecniche come il caricamento dei filtri via AJAX o pulsanti
<button>(invece di<a href>) per i filtri che non devono essere seguiti dai bot. Sebbene Googlebot possa eseguire JavaScript, tende a non interagire con elementi che non sembrano link di navigazione standard se non forzato. - Enforce dei Limiti: Lato server, se un URL contiene parametri non validi o combinazioni illogiche, deve restituire un codice di stato
404o410, non una pagina vuota con status200(Soft 404).
Conclusioni e Checklist Operativa
La gestione della faceted navigation per portali comparativi non è un’attività “set and forget”. Richiede un monitoraggio costante. Ecco la checklist definitiva per il 2026:
- Mappatura: Elencare tutti i parametri URL generati dal CMS.
- Prioritizzazione: Decidere quali combinazioni hanno volume di ricerca (Index) e quali no (Noindex/Block).
- Implementazione: Configurare
robots.txtper il risparmio budget enoindexper la pulizia dell’indice. - Automazione: Eseguire script Python mensili per verificare che Google rispetti le direttive.
- Log Analysis: Analizzare i log del server per vedere dove Googlebot spende il suo tempo. Se il 40% delle hit è su pagine
?order=, avete un problema di budget.
Adottando queste strategie ingegneristiche, portali complessi come MutuiperlaCasa.com possono dominare le SERP, garantendo che ogni scansione di Googlebot si traduca in valore reale per il business.
Domande frequenti

La navigazione a faccette genera un numero esponenziale di combinazioni URL, portando spesso all’esaurimento del Crawl Budget e al fenomeno dell’Index Bloat. Questo impedisce a Google di scansionare le pagine importanti ad alta conversione, diluisce il PageRank su risorse inutili e crea cannibalizzazione delle keyword tra migliaia di pagine simili.
La gestione ottimale richiede un approccio ibrido: il file robots.txt deve bloccare i parametri che non generano domanda di ricerca, come l’ordinamento per prezzo, per risparmiare risorse di scansione. Il meta tag noindex, invece, va applicato alle pagine che vogliamo far scoprire ai bot per seguire i link, ma che sono troppo granulari per essere indicizzate, come quelle con più di due filtri attivi.
Dipende dal volume di ricerca. La strategia migliore è l’URL Rewriting Selettivo: le combinazioni ad alta richiesta (High Demand) devono essere trasformate in URL statici e incluse nella Sitemap per massimizzare il posizionamento. I filtri a bassa richiesta (Low Demand) dovrebbero rimanere come parametri standard (?key=value) ed essere gestiti con noindex o bloccati per non disperdere autorità.
Per evitare che Googlebot rimanga intrappolato in loop infiniti, come filtri prezzo illimitati o calendari, è fondamentale usare l’obfuscation dei link. Si consiglia di caricare questi filtri tramite AJAX o utilizzare elementi button invece dei classici tag a href. Inoltre, il server deve restituire codici di stato 404 o 410 per combinazioni di parametri illogiche.
Per gestire grandi volumi di URL è necessario utilizzare script in Python che interrogano le API di Google Search Console. Questo permette di estrarre programmaticamente lo stato di copertura, identificare discrepanze tra il canonical dichiarato e quello scelto da Google, e rilevare parametri che vengono indicizzati per errore nonostante le regole di blocco.
Hai ancora dubbi su SEO Tecnica per Portali Comparativi: Gestione della Faceted Navigation?
Digita qui la tua domanda specifica per trovare subito la risposta ufficiale di Google.
Fonti e Approfondimenti


Hai trovato utile questo articolo? C’è un altro argomento che vorresti vedermi affrontare?
Scrivilo nei commenti qui sotto! Prendo ispirazione direttamente dai vostri suggerimenti.