

Imagens geradas com IA Detalhes
No panorama fintech de 2026, a capacidade de transformar documentos não estruturados em dados acionáveis tornou-se o principal fator diferenciador entre um processo de credit scoring eficiente e um obsoleto. O prompt engineering financeiro já não é uma simples competência acessória, mas uma componente crítica da arquitetura de software bancário. Este guia técnico explora como projetar pipelines de IA robustas para a extração de dados de recibos de vencimento, balanços XBRL/PDF e extratos bancários, minimizando os riscos operacionais.
O Problema dos Dados Não Estruturados no Credit Scoring
Apesar da evolução das normas digitais, uma parte significativa da documentação necessária para a análise de crédito (especialmente para PME e particulares) ainda chega em formatos não estruturados: PDF digitalizados, imagens ou ficheiros de texto desordenados. O objetivo é converter este caos num objeto JSON validado que possa alimentar diretamente os algoritmos de avaliação de risco.
Os principais desafios incluem:
- Ambiguidade Semântica: Distinguir entre “Rendimento Bruto” e “Matéria Coletável” em recibos de vencimento com layouts proprietários.
- Alucinações Numéricas: A tendência dos LLM para inventar números ou errar cálculos se não forem corretamente instruídos.
- Ruído de OCR: Erros de leitura (ex. confundir um ‘0’ com um ‘O’ ou um ‘8’ com um ‘B’).
Arquitetura da Pipeline de Extração
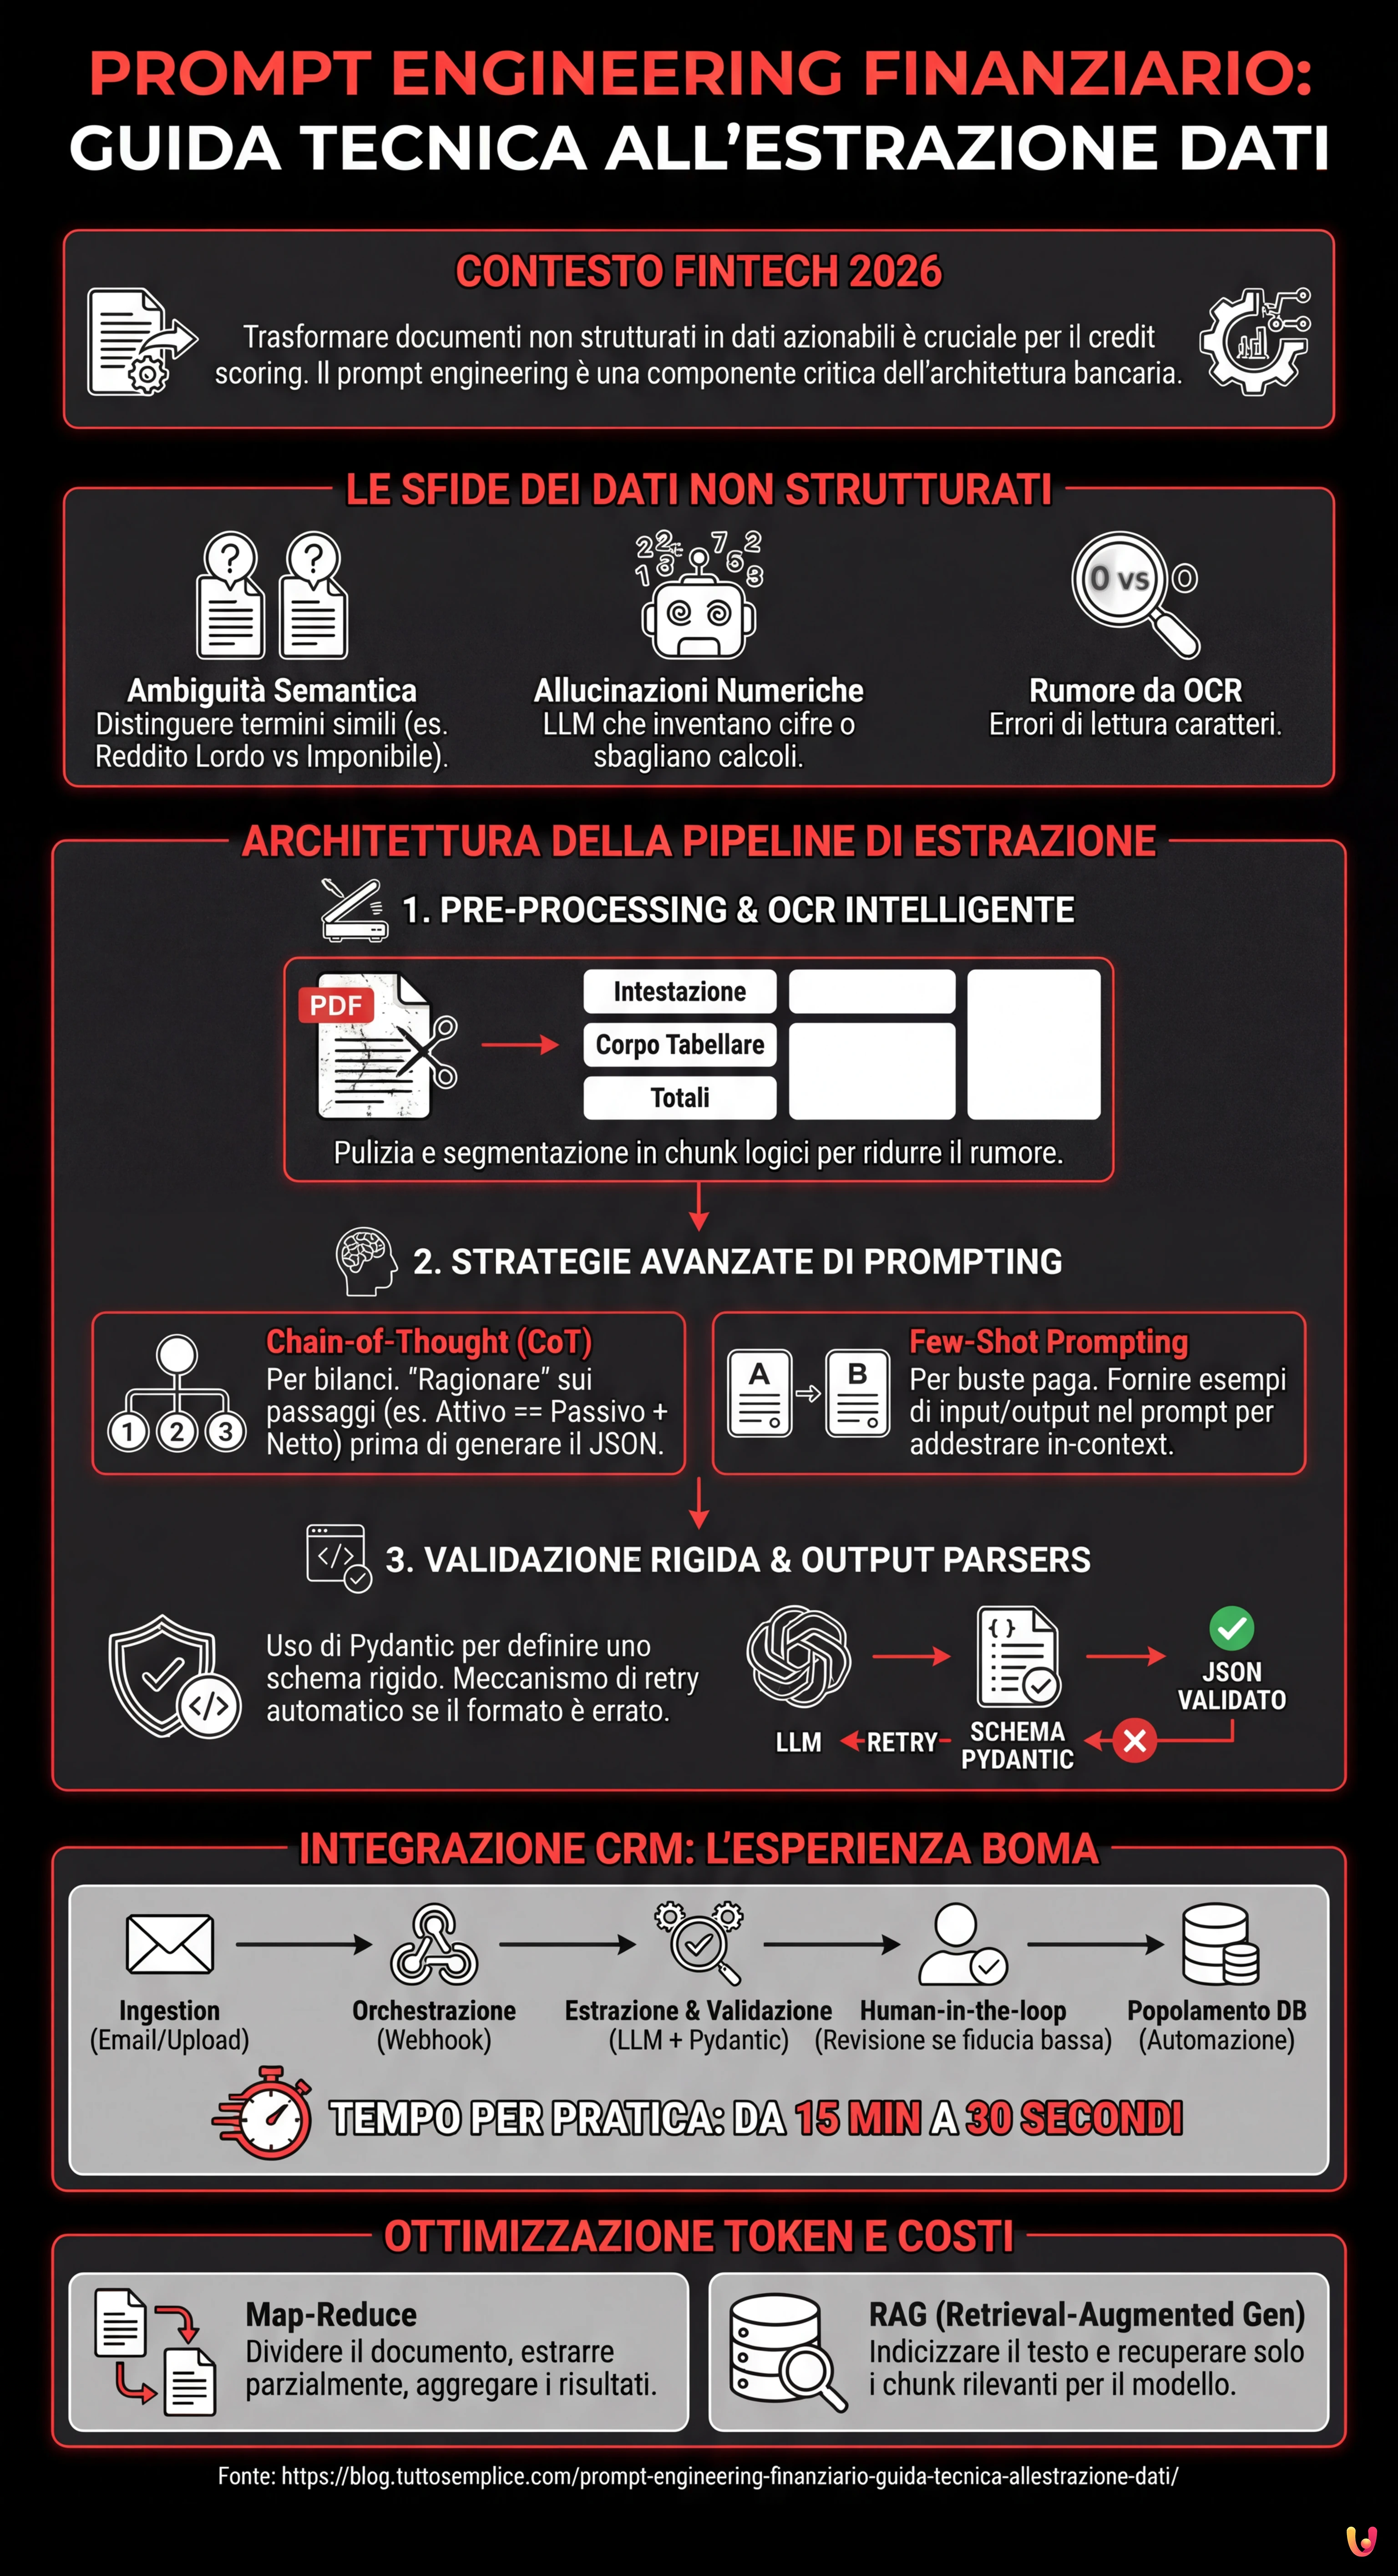 Imagem gerada com IA
Para construir um sistema fiável, não basta enviar um PDF para um modelo como o GPT-4o ou Claude. É necessária uma orquestração complexa, gerida tipicamente através de frameworks como LangChain ou LlamaIndex.
1. Pré-processamento e OCR Inteligente
Antes de aplicar qualquer técnica de prompt engineering financeiro, o documento deve ser “limpo”. O uso de OCR avançados é obrigatório. Nesta fase, é útil segmentar o documento em chunks lógicos (ex. “Cabeçalho”, “Corpo da Tabela”, “Totais”) para evitar saturar a context window do modelo com ruído inútil.
2. Estratégias Avançadas de Prompting
Aqui reside o coração da técnica. Um prompt genérico como “Extrai os dados” falhará em 90% dos casos complexos. Eis as metodologias vencedoras:
Chain-of-Thought (CoT) para a Validação Lógica
Para os balanços empresariais, é fundamental que o modelo “raciocine” antes de responder. Utilizando o CoT, forçamos o LLM a explicitar os passos intermédios.
SYSTEM PROMPT:
És um analista financeiro experiente. A tua tarefa é extrair os dados do balanço.

USER PROMPT:
Analisa o texto fornecido. Antes de gerar o JSON final, executa estes passos:
1. Identifica o Total do Ativo e o Total do Passivo.
2. Verifica se Ativo == Passivo + Capital Próprio.
3. Se as contas não baterem certo, assinala a incongruência no campo 'warning'.
4. Apenas no final gera o output JSON.
Few-Shot Prompting para Recibos de Vencimento Heterogéneos
Os recibos de vencimento variam enormemente entre diferentes empregadores. O Few-Shot Prompting consiste em fornecer ao modelo exemplos de input (texto bruto) e output desejado (JSON) dentro do próprio prompt. Isto “treina” o modelo in-context a reconhecer padrões específicos sem necessidade de fine-tuning.
EXEMPLO 1:
Input: "Total de abonos: 2.500,00 euros. Líquido a receber: 1.850,00."
Output: {"bruto": 2500.00, "liquido": 1850.00}

EXEMPLO 2:
Input: "Bruto mensal: € 3.000. Total de descontos: € 800. Líquido a pagar: € 2.200."
Output: {"bruto": 3000.00, "liquido": 2200.00}

TAREFA:
Input: [Novo Texto Recibo Vencimento]...Mitigação das Alucinações e Validação
 Imagem gerada com IA
No âmbito financeiro, uma alucinação (inventar um número) é inaceitável. Para mitigar este risco, implementamos uma validação rígida pós-processamento.
Output Parsers e Pydantic
Utilizando bibliotecas como Pydantic em Python, podemos definir um esquema rígido que o modelo deve respeitar. Se o LLM gerar um campo “data” num formato errado ou uma string em vez de um float, o validador levanta uma exceção e, através de um mecanismo de retry, pede ao modelo para se corrigir.
Integração CRM: A Experiência BOMA
A aplicação prática destas técnicas encontra a sua expressão máxima na integração com sistemas proprietários. No contexto do projeto BOMA (Back Office Management Automation), a integração da pipeline de IA seguiu estes passos:
- Ingestão: O CRM recebe o documento via email ou upload.
- Orquestração: Um webhook ativa a pipeline LangChain.
- Extração & Validação: O LLM extrai os dados e o Pydantic valida-os.
- Human-in-the-loop: Se o confidence score for baixo, o sistema cria uma tarefa no CRM para uma revisão manual, destacando os campos suspeitos.
- Povoamento: Os dados validados povoam automaticamente os campos da BD, reduzindo o tempo de introdução de dados de 15 minutos para 30 segundos por processo.
Otimização dos Tokens e dos Custos
Gerir a token window é essencial para manter os custos das API sustentáveis, especialmente com balanços de centenas de páginas.
- Map-Reduce: Em vez de passar o documento inteiro de uma vez, divide-se o texto em secções, extraem-se os dados parciais e pede-se a um segundo prompt para os agregar.
- RAG (Retrieval-Augmented Generation): Para documentos muito extensos, indexa-se o texto numa base de dados vetorial e recuperam-se apenas os chunks relevantes (ex. apenas as páginas relativas à “Demonstração de Resultados”) para passar ao modelo.
Em Resumo (TL;DR)
O prompt engineering financeiro converte documentos não estruturados em dados JSON validados para otimizar o credit scoring moderno.
Estratégias técnicas como Chain-of-Thought e Few-Shot Prompting garantem extrações precisas mitigando os riscos de alucinações numéricas.
A integração de pipelines de IA com validação automática reduz os tempos operacionais e melhora a fiabilidade dos processos bancários.
Conclusões

O prompt engineering financeiro é uma disciplina que requer rigor. Não se trata apenas de saber “falar” com a IA, mas de construir uma infraestrutura de controlo à sua volta. Através do uso combinado de Chain-of-Thought, Few-Shot Prompting e validadores de esquema, é possível automatizar a análise do risco de crédito com um nível de precisão que em 2026 compete com, e muitas vezes supera, a precisão humana.
Perguntas frequentes

O prompt engineering financeiro é uma disciplina técnica focada na conceção de instruções precisas para modelos de inteligência artificial, destinada a transformar documentos não estruturados, como recibos de vencimento e balanços, em dados estruturados. No setor fintech, esta competência tornou-se crucial para automatizar o credit scoring, permitindo converter formatos caóticos como PDF e digitalizações em objetos JSON validados, reduzindo drasticamente os tempos de processamento e os riscos operacionais.
Para prevenir que os modelos linguísticos inventem números ou cometam erros de cálculo, é necessário implementar uma validação rígida pós-processamento utilizando bibliotecas como Pydantic, que impõem um esquema fixo ao output. Além disso, o uso de estratégias de prompting como o Chain-of-Thought obriga o modelo a explicitar os passos lógicos intermédios, como verificar se o total do ativo corresponde ao passivo mais o capital próprio, antes de gerar o resultado final.
As técnicas variam consoante o tipo de documento. Para os balanços empresariais, que requerem coerência lógica, é preferível o Chain-of-Thought que guia o raciocínio do modelo. Para documentos heterogéneos como os recibos de vencimento, resulta mais eficaz o Few-Shot Prompting, que consiste em fornecer ao modelo exemplos concretos de input e output desejado dentro do próprio prompt, ajudando-o a reconhecer padrões específicos sem necessidade de um novo treino.
Para documentos extensos que arriscam saturar a memória do modelo ou aumentar os custos, utilizam-se técnicas de otimização de tokens. A abordagem Map-Reduce divide o documento em secções mais pequenas para extrações parciais posteriormente agregadas. Alternativamente, a técnica RAG (Retrieval-Augmented Generation) permite recuperar e analisar apenas os fragmentos de texto realmente pertinentes, como as tabelas específicas de um balanço, ignorando as partes não necessárias.
O OCR inteligente representa o primeiro passo fundamental para limpar o documento antes da análise de IA. Uma vez que muitos documentos chegam como digitalizações ou imagens, um OCR avançado é necessário para converter estes ficheiros em texto legível e segmentá-los em blocos lógicos. Isto reduz o ruído causado por erros de leitura e prepara o terreno para um prompt engineering eficaz, evitando que o modelo seja confundido por dados desordenados.
Ainda tem dúvidas sobre Prompt Engineering Financeiro: Guia Técnico de Extração de Dados?
Digite sua pergunta específica aqui para encontrar instantaneamente a resposta oficial do Google.
Fontes e Aprofundamento

- Prompt Engineering: Conceitos Técnicos e Modelos de Linguagem (Wikipedia)
- Introdução ao XBRL: O Padrão Global para Relatórios de Negócios (XBRL International)
- Pedir o mapa de responsabilidades de crédito – ePortugal.gov.pt
- Artificial Intelligence and Machine Learning in Market Operations (Bank for International Settlements)
- Reconhecimento Ótico de Caracteres (OCR) na Digitalização de Documentos (Wikipedia)


Achou este artigo útil? Há outro assunto que gostaria de me ver abordar?
Escreva nos comentários aqui em baixo! Inspiro-me diretamente nas vossas sugestões.